0
0
0
【中软设】2.5 计算机组成与体系结构-CPU、存储体系、Cache
# CPU

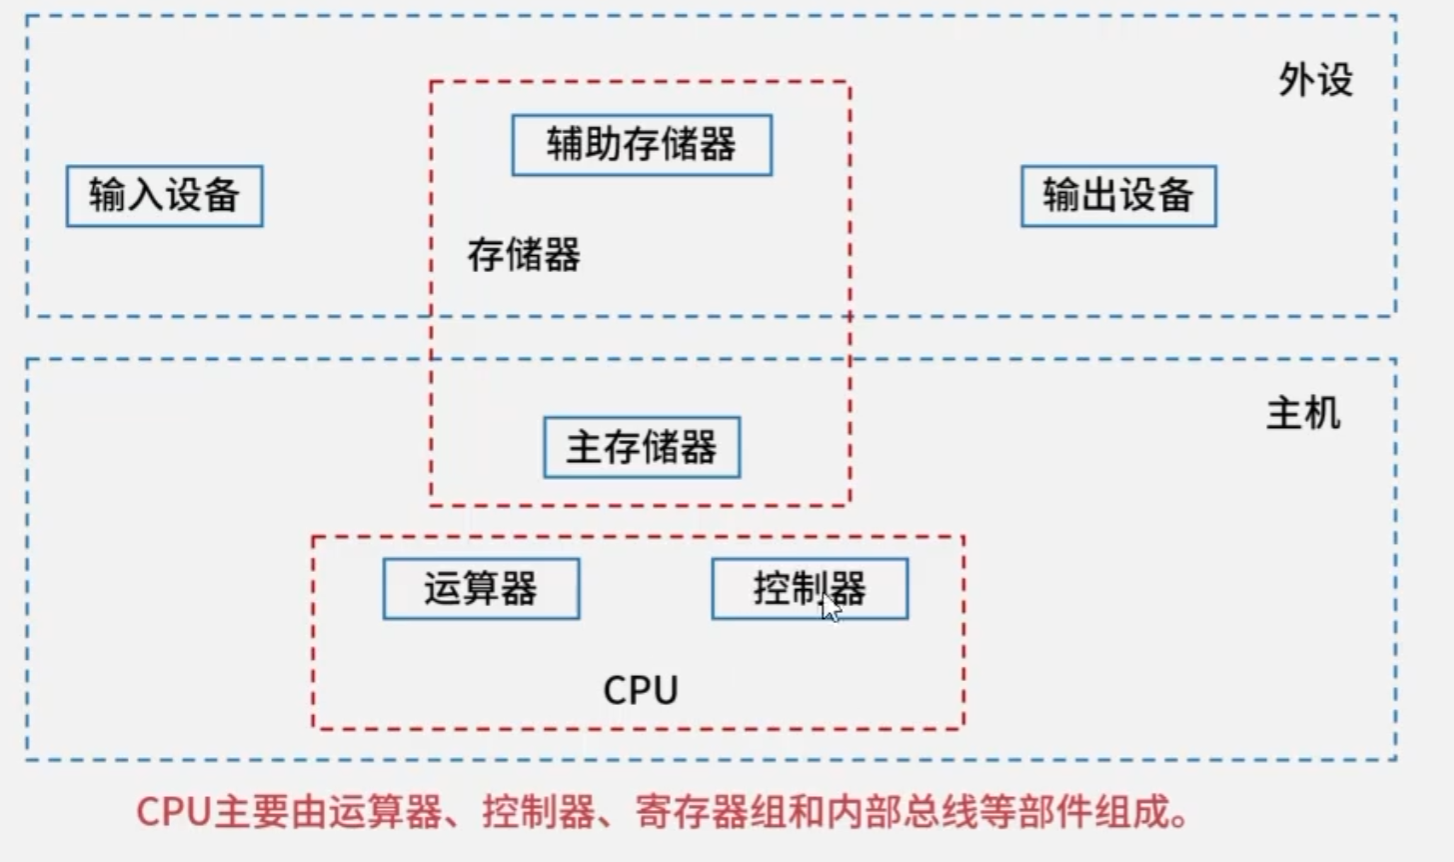
CPU 是计算机的“大脑”:**运算器埋头干活,控制器发号施令**,再配上一套分层存储系统和 Cache,程序才能跑起来。本文按“组成 → 存储 → 缓存”的顺序逐层拆解。
## 1. CPU 的组成
CPU 内部主要就是两大部件,分工像一个车间:
| 部件 | 角色 | 一句话职责 |
| --- | --- | --- |
| **运算器** | 干活的工人 | 完成算术运算与逻辑运算 |
| **控制器** | 车间主任 | 取指令、译指令、产生控制信号指挥全厂 |
内部结构示意:
```mermaid
flowchart LR
subgraph CU["控制器(发号施令)"]
PC["PC 程序计数器
下一条指令的地址"] AR["AR 地址寄存器
当前要访问的内存地址"] IR["IR 指令寄存器
正在执行的指令本体"] ID["ID 指令译码器
翻译操作码"] CLK["时序部件
打节拍,同步操作"] end subgraph AU["运算器(埋头干活)"] ALU["ALU 算术逻辑单元
负责算"] AC["AC 累加寄存器
暂存数据"] DR["DR 数据缓冲寄存器
数据中转站"] PSW["PSW 状态条件寄存器
记录运算状态"] end MEM[("内存")] PC --> AR --> MEM MEM --> DR --> IR --> ID ID -->|控制信号| ALU ALU --> AC ALU --> PSW ``` ### 1.1 运算器 运算器像一张“工作台”:ALU 是台面上真正干活的工具,AC 是手边的托盘,DR 是传送带出入口,PSW 是每件活做完后贴的标签。 1. **算术逻辑单元 ALU**:数据的算术运算和逻辑运算 2. **累加寄存器 AC**:通用寄存器,为 ALU 提供一个工作区,用于暂存数据 3. **数据缓冲寄存器 DR**:写内存时,暂存指令或数据 4. **状态条件寄存器 PSW**:存状态标志与控制标志(如结果为负、为零、进位、溢出) > 争议:也有将其(PSW)归为控制器的。不同教材归类不同,考试时以所报教程为准。 ### 1.2 控制器 控制器是“车间主任”:不亲手干活,但决定**干什么、什么时候干、派谁去干**。 1. **程序计数器 PC**:存储下一条要执行指令的地址 2. **指令寄存器 IR**:存储即将执行的指令 3. **指令译码器 ID**:对指令中的操作码字段进行分析解释 4. **地址寄存器 AR**:保存当前 CPU 访问内存单元的地址 5. **时序部件**:提供时序控制信号 一图速记各部件分工: > - ALU:**算** > - AC:**临时放运算数据结果** > - DR:**CPU ↔内存 数据中转站** > - PSW:**运算状态标记** > - PC:**下一条指令在哪(地址)** > - IR:**当前要执行的指令本体** > - ID:**翻译指令** > - AR:**要访问内存的地址** > - 时序部件:**打节拍,同步所有操作** #### 1.2.1 取指令简单流程 1. PC 给出下一条指令地址 → 送到 AR,访问内存 2. 内存把指令读出,经过 DR,送到 IR 保存 3. IR 的指令交给 ID 译码翻译 4. 译码后发出控制信号,ALU 开始运算,AC 暂存运算数据,PSW 记录运算状态 5. PC 更新,准备取下一条指令 ```mermaid flowchart TD S1["① 取指:PC → AR → 访问内存"] S2["② 读出:内存 → DR → IR"] S3["③ 译码:IR → ID 翻译指令"] S4["④ 执行:发控制信号
ALU 运算 · AC 暂存 · PSW 记状态"] S5["⑤ PC 更新,准备取下一条"] S1 --> S2 --> S3 --> S4 --> S5 --> S1 ``` 这五步不断循环,就是 CPU 执行程序的“心跳”。**控制器取令发令、运算器执行计算,周而复始,程序就这样一条条跑完。** #### 1.2.2 例题 计算机执行指令的过程中,需要由( )产生每条指令的操作信号并将信号送往相应的部件进行处理,以完成指定的操作。 A、CPU 的控制器 B、CPU 的运算器 C、DMA 控制器 D、Cache 控制器 **答案:A**✅ #### 1.2.3 解析 - **A、CPU 的控制器**:控制器是 CPU 的指挥中心。读取指令、译码之后,**产生操作控制信号,发给各个硬件部件,指挥完成指令动作**,和题干描述完全匹配。 - **B、CPU 的运算器**:只负责做算术、逻辑计算,**不产生控制信号**。 - **C、DMA 控制器**:负责外设和内存直接高速传输数据,和普通指令执行无关。 - **D、Cache 控制器**:管理高速缓存,负责缓存和内存的数据调度,不产生指令操作信号。 #### 1.2.4 考点记忆 > ✨**控制器 = 发号施令(产生控制信号)** > ✨**运算器 = 埋头干活(做计算)** 题干只要出现“**产生操作(控制)信号并送往部件**”,直接锁定控制器。 ## 2. 存储系统 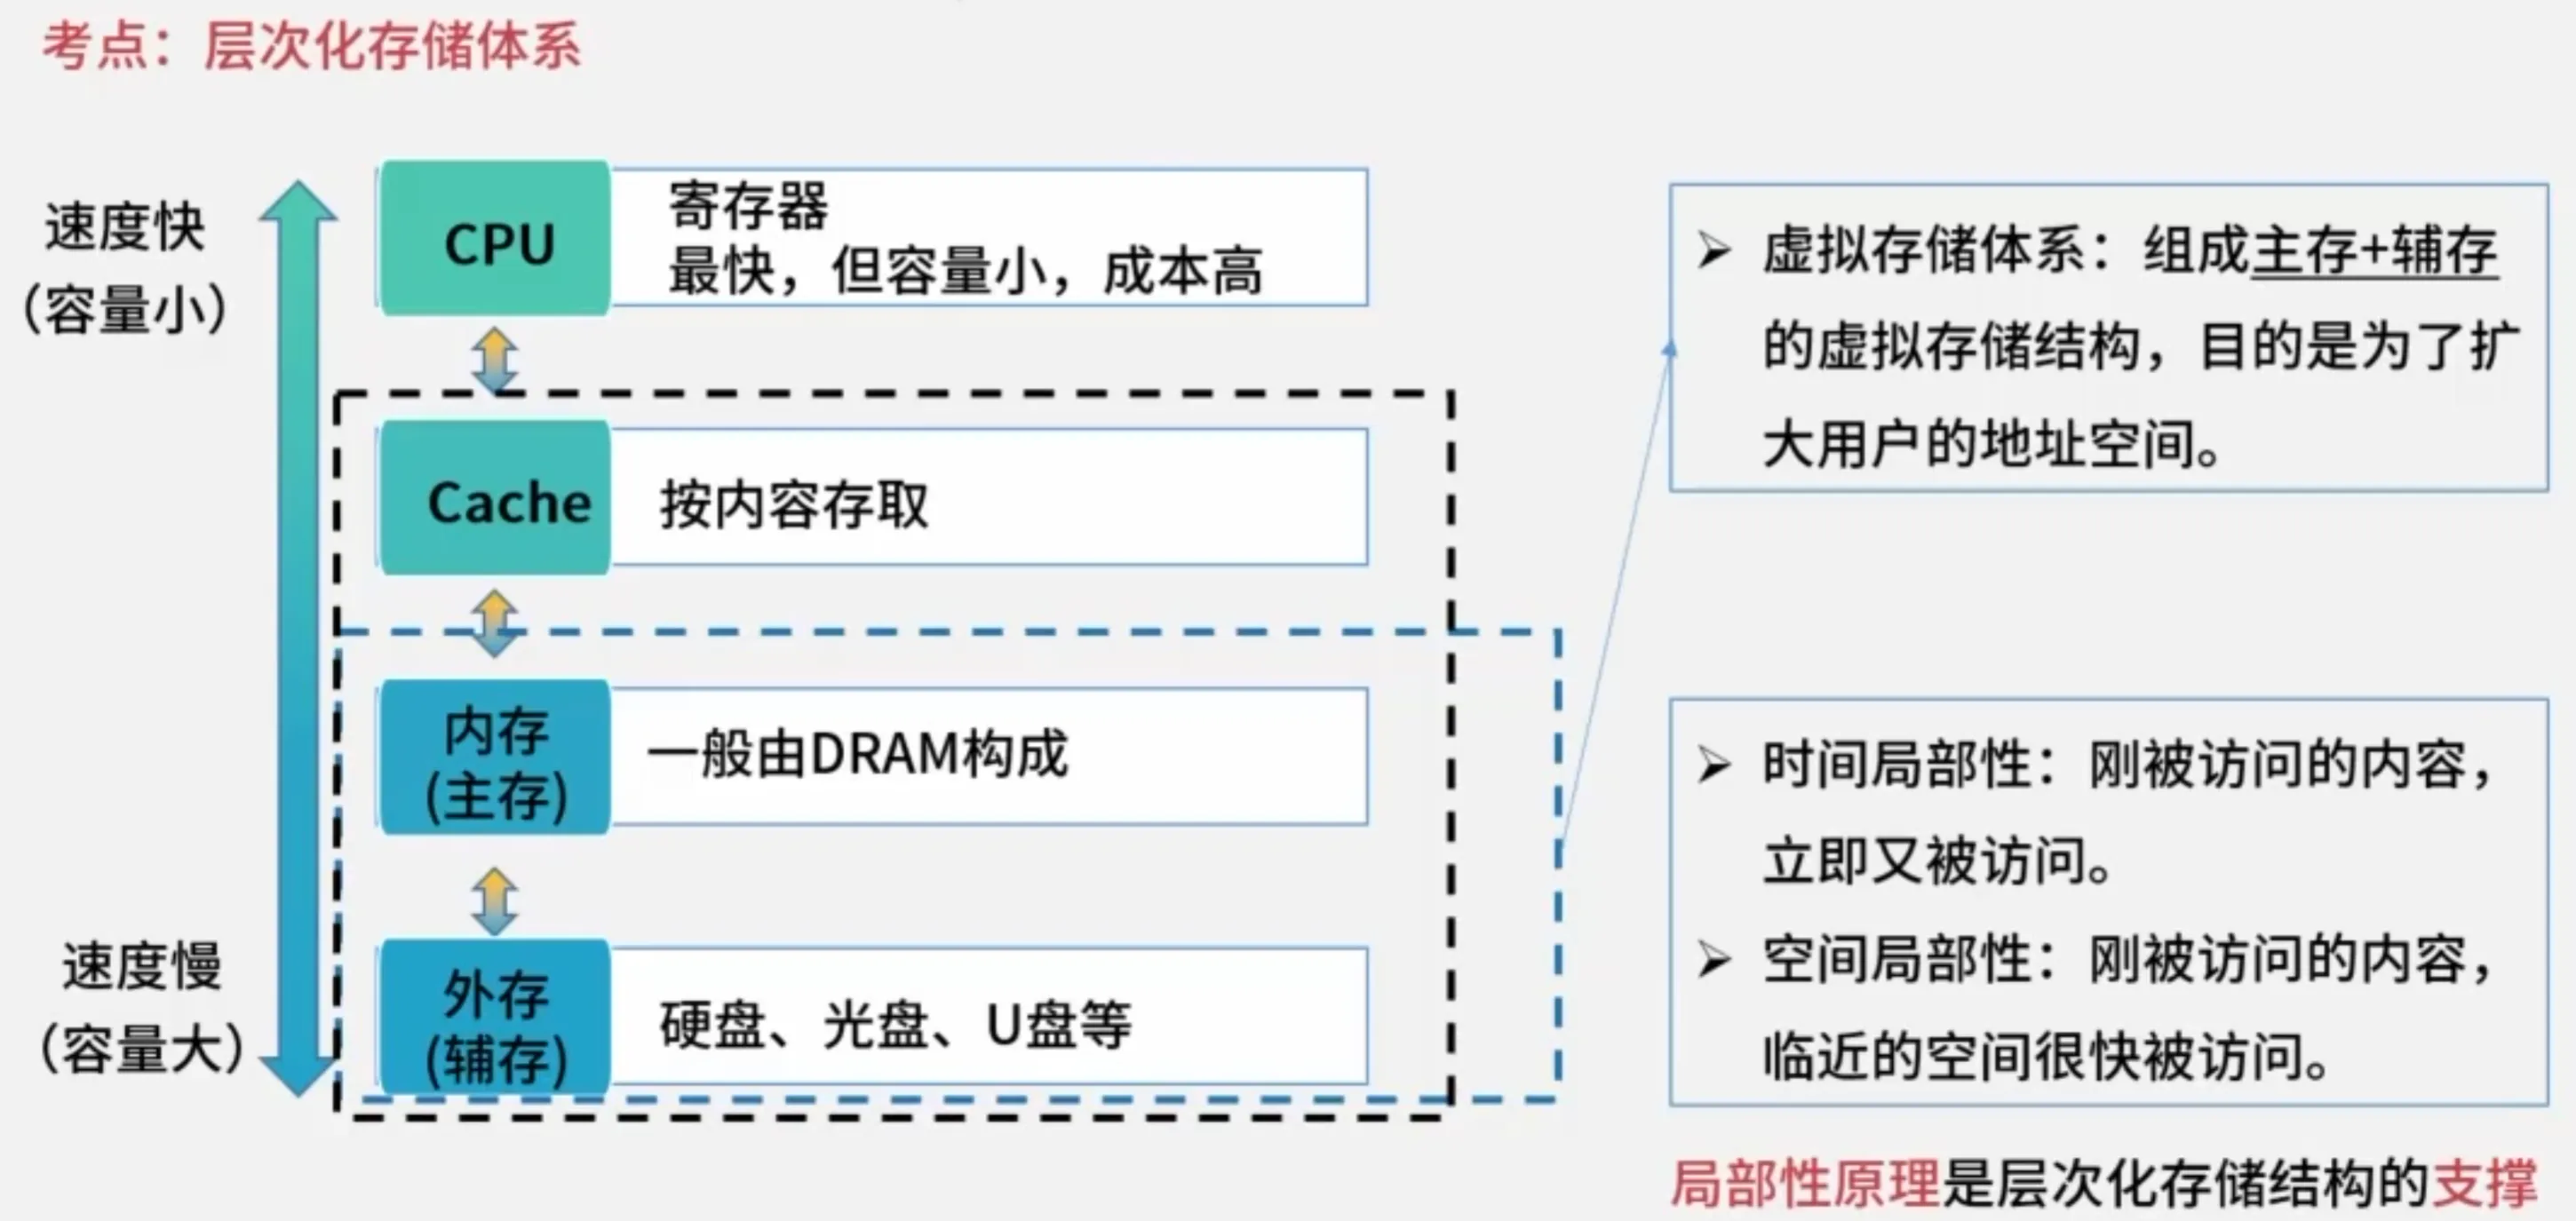 理想的存储器要同时满足三个愿望:**快、大、便宜**——但它们互相矛盾:快的贵,便宜的大而慢。工程师的解法是**分层**:最快的放离 CPU 最近处,最大的放远处,靠调度来兼顾三者。 ### 2.1 层次化存储体系 | 层级 | 离 CPU | 速度 | 容量 | 单位成本 | 断电后 | | --- | --- | --- | --- | --- | --- | | 寄存器 | 最近(CPU 内) | 最快 | 最小 | 最高 | 丢失 | | Cache | 很近 | 快 | 小 | 高 | 丢失 | | 主存(内存) | 较近 | 中 | 中 | 中 | 丢失 | | 外存(硬盘/U盘) | 最远 | 慢 | 最大 | 最低 | 保留 | **核心规律:越靠近 CPU,越快、越贵、越小;越远离 CPU,越慢、越便宜、越大。** #### 2.1.1 存储器位置 - **内存(主存)**:CPU 可以直接访问,存放正在运行的程序和数据。 - **外存(辅存)**:CPU 不能直接访问,数据必须先调入内存才能处理(如硬盘、U 盘)。 #### 2.1.2 存取方式 (1)按内容存取:相联存储器(如 Cache)——不问地址,按“内容”并行比对查找。 (2)按地址存取: | 方式 | 怎么取 | 通俗类比 | 典型代表 | | --- | --- | --- | --- | | 随机存取 | 给地址直接取,耗时与位置无关 | 按门牌号直接进房间 | 内存(RAM) | | 顺序存取 | 从头到尾依次找 | 磁带找歌必须倒带 | 磁带 | | 直接存取 | 先定位到区域,再在区域内顺序找 | 硬盘:先挪磁头到磁道,再等盘片转到扇区 | 磁盘 | 直接存取是介于随机和顺序之间的一种方式。 #### 2.1.3 工作方式 (1)随机存取存储器 RAM(如内存 DRAM) (2)只读存储器 ROM(如 BIOS) 四种常见存储芯片横向对比: | 类型 | 归类 | 擦写粒度 | 特点 | 典型用途 | | --- | --- | --- | --- | --- | | DRAM | RAM | — | 动态:靠电容存电荷,需刷新;集成度高、成本低 | 主存(内存条) | | SRAM | RAM | — | 静态:不需要刷新;速度快、集成度低、成本高 | Cache | | EEPROM | ROM | 按字节 | 电可擦写,小粒度、更灵活 | 主板 BIOS 配置 | | Flash | ROM | 按块 | 闪存,擦写更快、密度高 | U 盘、固态硬盘 | > **电可擦除**:不需要拔芯片、不需要紫外线照射,**通电加特定电压,就可以擦掉芯片里保存的数据,重新写入新内容**。 > - ✅用电信号就擦除,不用拆芯片 > - ✅**按字节擦写**:可以只改其中某一小部分数据,不用整片清空 > - ✅断电之后数据不会丢 > - 用途:主板 BIOS 小配置、保存少量参数 ### 2.2 例题 1 CPU访问存储器时,被访问数据一般聚集在一个较小的连续存储区域中。若一个存储单元已被访问,则其邻近的存储单元有可能还要被访问,该特性被称为( )。 A、数据局部性 B、指令局部性 C、空间局部性 D、时间局部性 **答案:C** 解析: - **空间局部性**:刚访问过的存储单元,它相邻/邻近的单元很可能马上被访问(地址相邻)。 - **时间局部性**:刚访问过的存储单元,不久之后还会再次访问(同一个地址重复用)。 判断口诀:**看到“邻近/相邻的单元”→ 空间局部性;看到“不久后再次访问”→ 时间局部性。** > ✨空间局部性 = **隔壁邻居马上也要被访问** > ✨时间局部性 = **同一个地点,回头客再来一次** 正是“空间 + 时间”这两种局部性,让下一节的 Cache 有了存在的前提:**把最近可能用到的数据提前搬到快的地方**。 ### 2.3 例题 2 计算机系统的主存主要是由( )构成的。 A、DRAM B、SRAM C、Cache D、EEPROM **答案:A** 解析: - **DRAM**:动态随机存储器,用来做**主存(内存)**,需要刷新,成本低、容量大。 - **SRAM**:静态随机存储器,用来做**Cache 高速缓存**,不用刷新,成本高。 - **Cache**:高速缓存,不是存储器芯片类型,是一种高速存储层级。 - **EEPROM**:电可擦除只读存储器,断电数据不丢失。 > ✨**便宜大碗做主存(DRAM),快而金贵做缓存(SRAM)**——这是高频固定搭配。 ## 3. Cache CPU 的速度远快于主存,直接干等主存就像跑车堵在乡间小路。解法:在 CPU 与主存之间加一层 **Cache(用 SRAM 实现)**,依据局部性原理,把最近、最常要用的那部分数据提前搬进来,让 CPU 大多数时候“就地取材”。 ### 3.1 Cache 的访问命中率 在计算机的存储系统体系中,Cache 是访问速度最快的层次(若有寄存器,则寄存器最快)。 速度排序:**寄存器 > Cache > 主存 > 外存** - $h$:Cache 访问命中率 - $t_1$:Cache 的周期时间 - $t_2$:主存储器周期时间 - $t_3$:“Cache + 主存储器”系统的平均周期(读操作) 公式: $$ t_3 = h \times t_1 + (1-h) \times t_2 $$ > $(1-h)$:失效率(未命中率) 公式的直觉:**命中的概率走 Cache 那条快路,未命中的概率走主存那条慢路,加权平均就是平均耗时。** 算一笔账:若命中率 $h = 0.9$,$t_1 = 1\,\text{ns}$,$t_2 = 10\,\text{ns}$,则 $$ t_3 = 0.9 \times 1 + 0.1 \times 10 = 1.9\,\text{ns} $$ 只用一小块 SRAM,平均访问时间就从 10ns 压到 1.9ns。**命中率是 Cache 的生命线:命中率越高,平均访问时间越接近 Cache 的速度。** ### 3.2 Cache 的三种地址映像方式 主存容量大、Cache 容量小,主存的每一块放进 Cache 时“坐哪儿”,就是**地址映像**要解决的问题。三种映像,本质是三种松紧不同的“座位制度”。 #### 3.2.1 直接相联映像 直接相联映像:地址映像是将主存与 Cache 的存储空间划分为若干大小相同的页(或称为块),**根据编号直接映射**。 > 规则:主存**各区页号相同**的页,只能映射到 Cache 里同一个页位置。 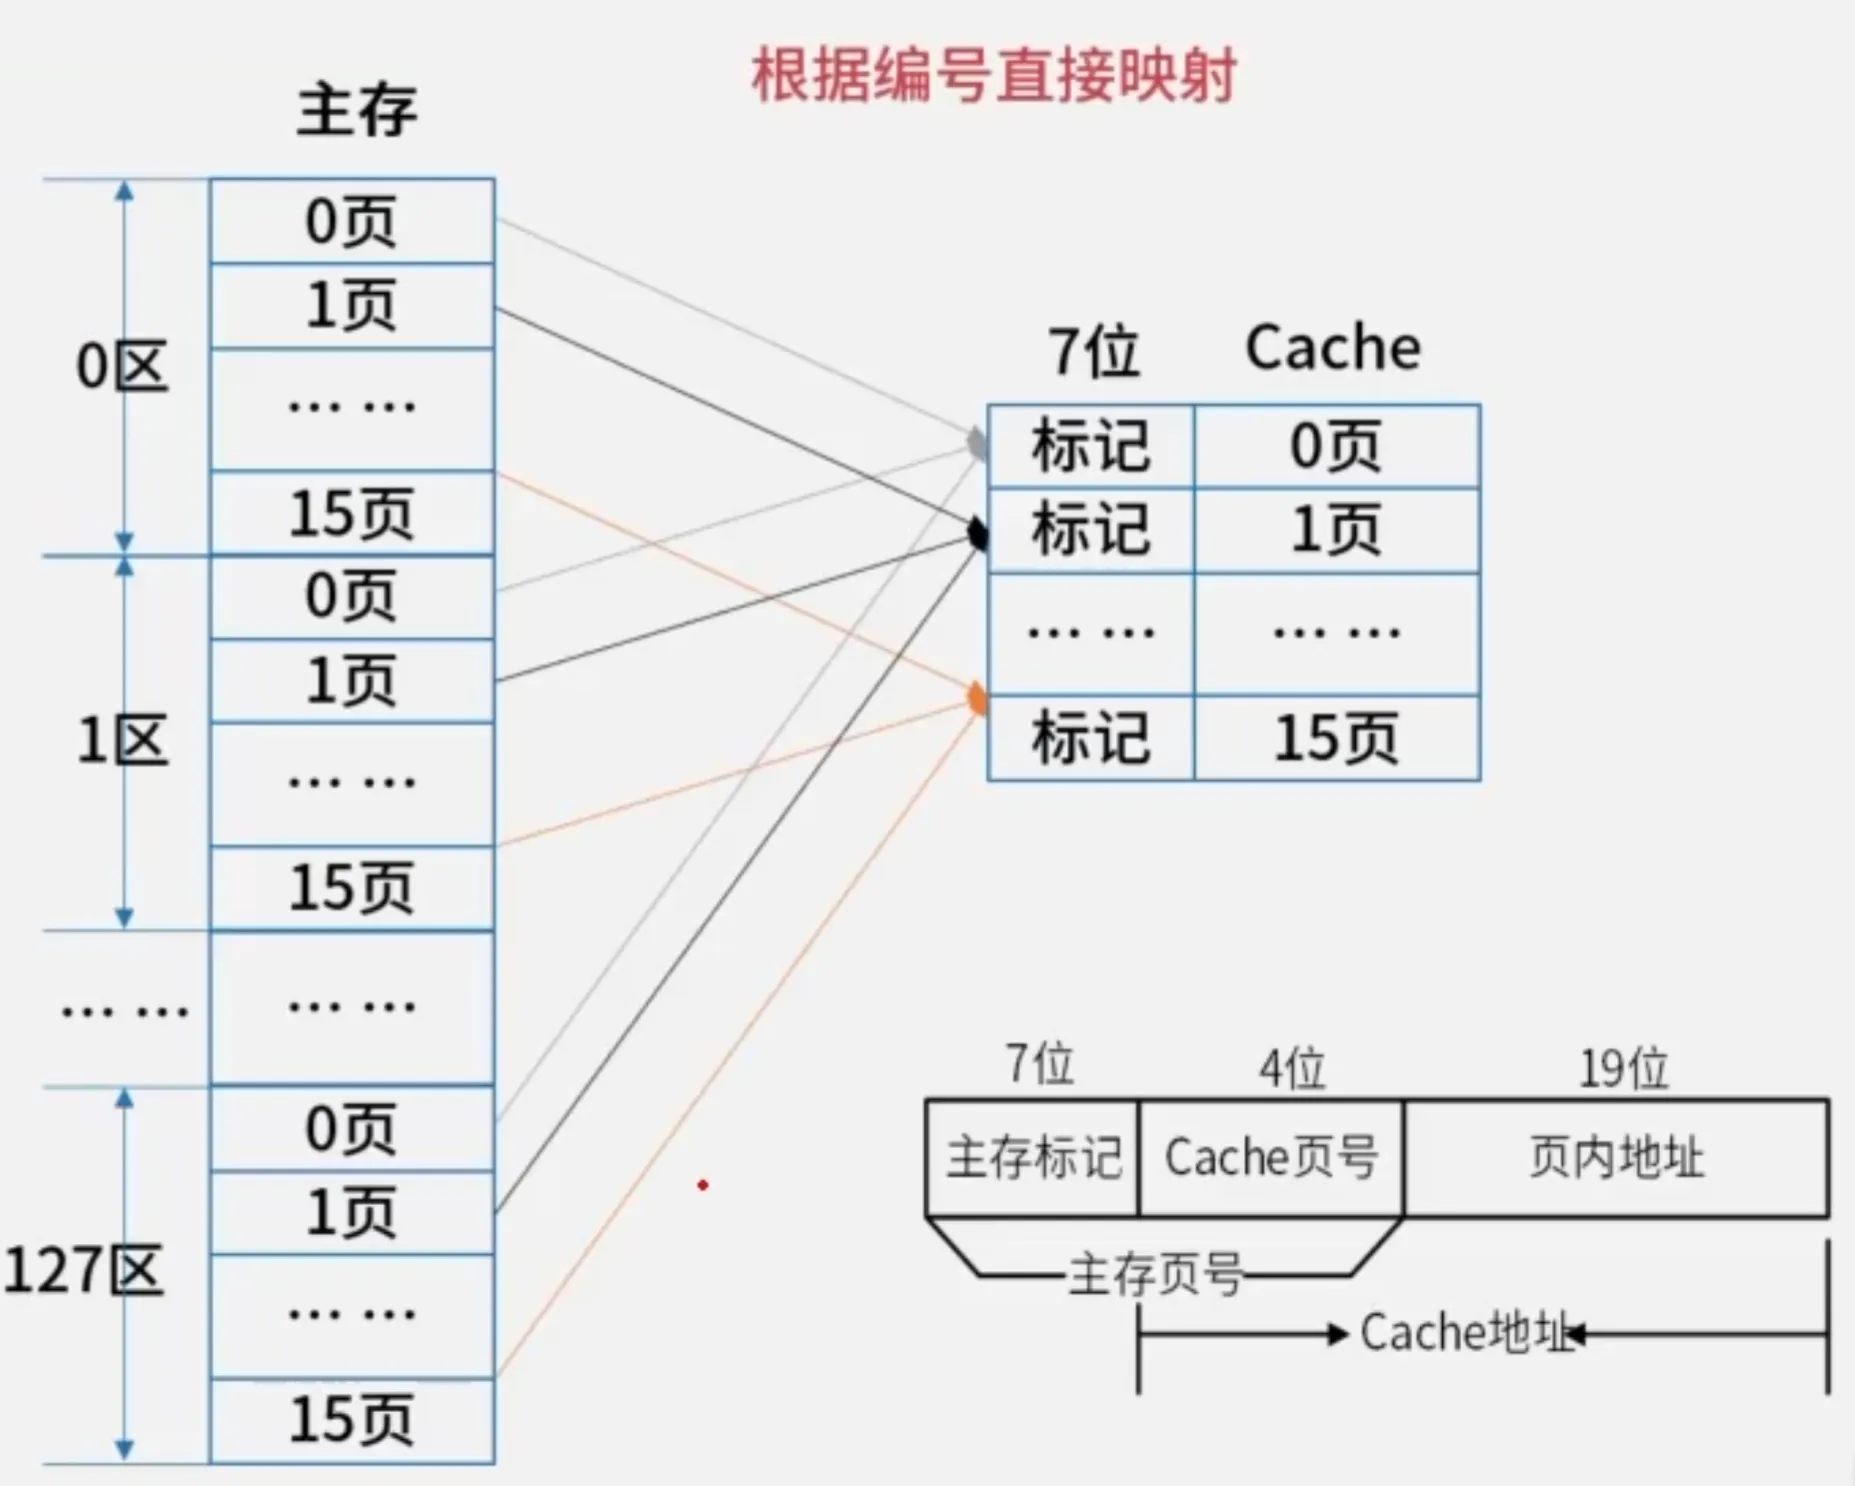 类比:**对号入座,一人一座**——主存的块按编号永远坐 Cache 的同一个座位,不管别处空不空。 - 优点:映像规则简单,地址变换快,**硬件成本最低** - 缺点:主存中同页号的块都挤同一个座位,**冲突率高、Cache 利用率低、命中率低** #### 3.2.2 全相联映像 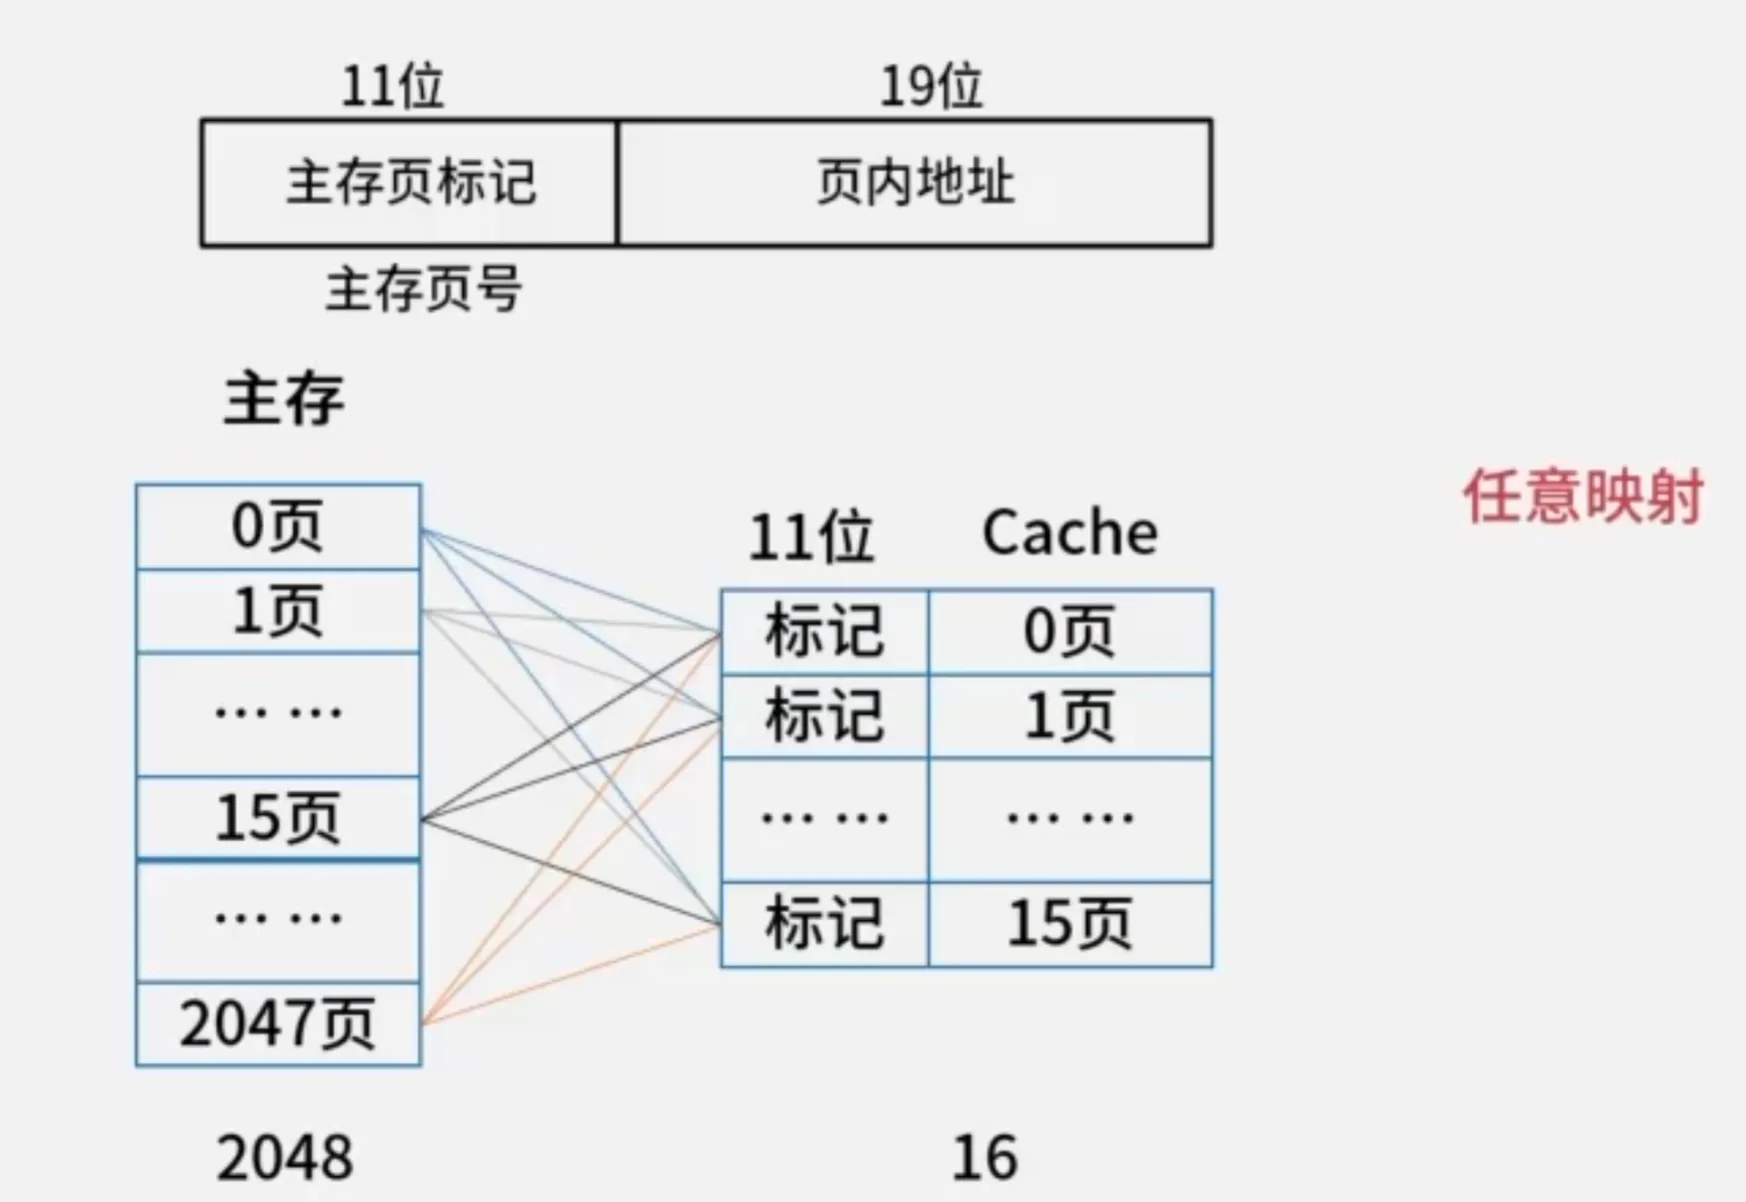 规则:**主存的任意一页,可以映射到 Cache 的任意一页**,没有任何座位限制。 类比:**自由入座,哪个空位坐哪个**。 - 优点:最灵活,冲突率最低,**命中率最高** - 缺点:判断“数据在不在 Cache”要和**所有**页的标记逐一比较,电路复杂、成本高、速度慢 #### 3.2.3 组相联映像 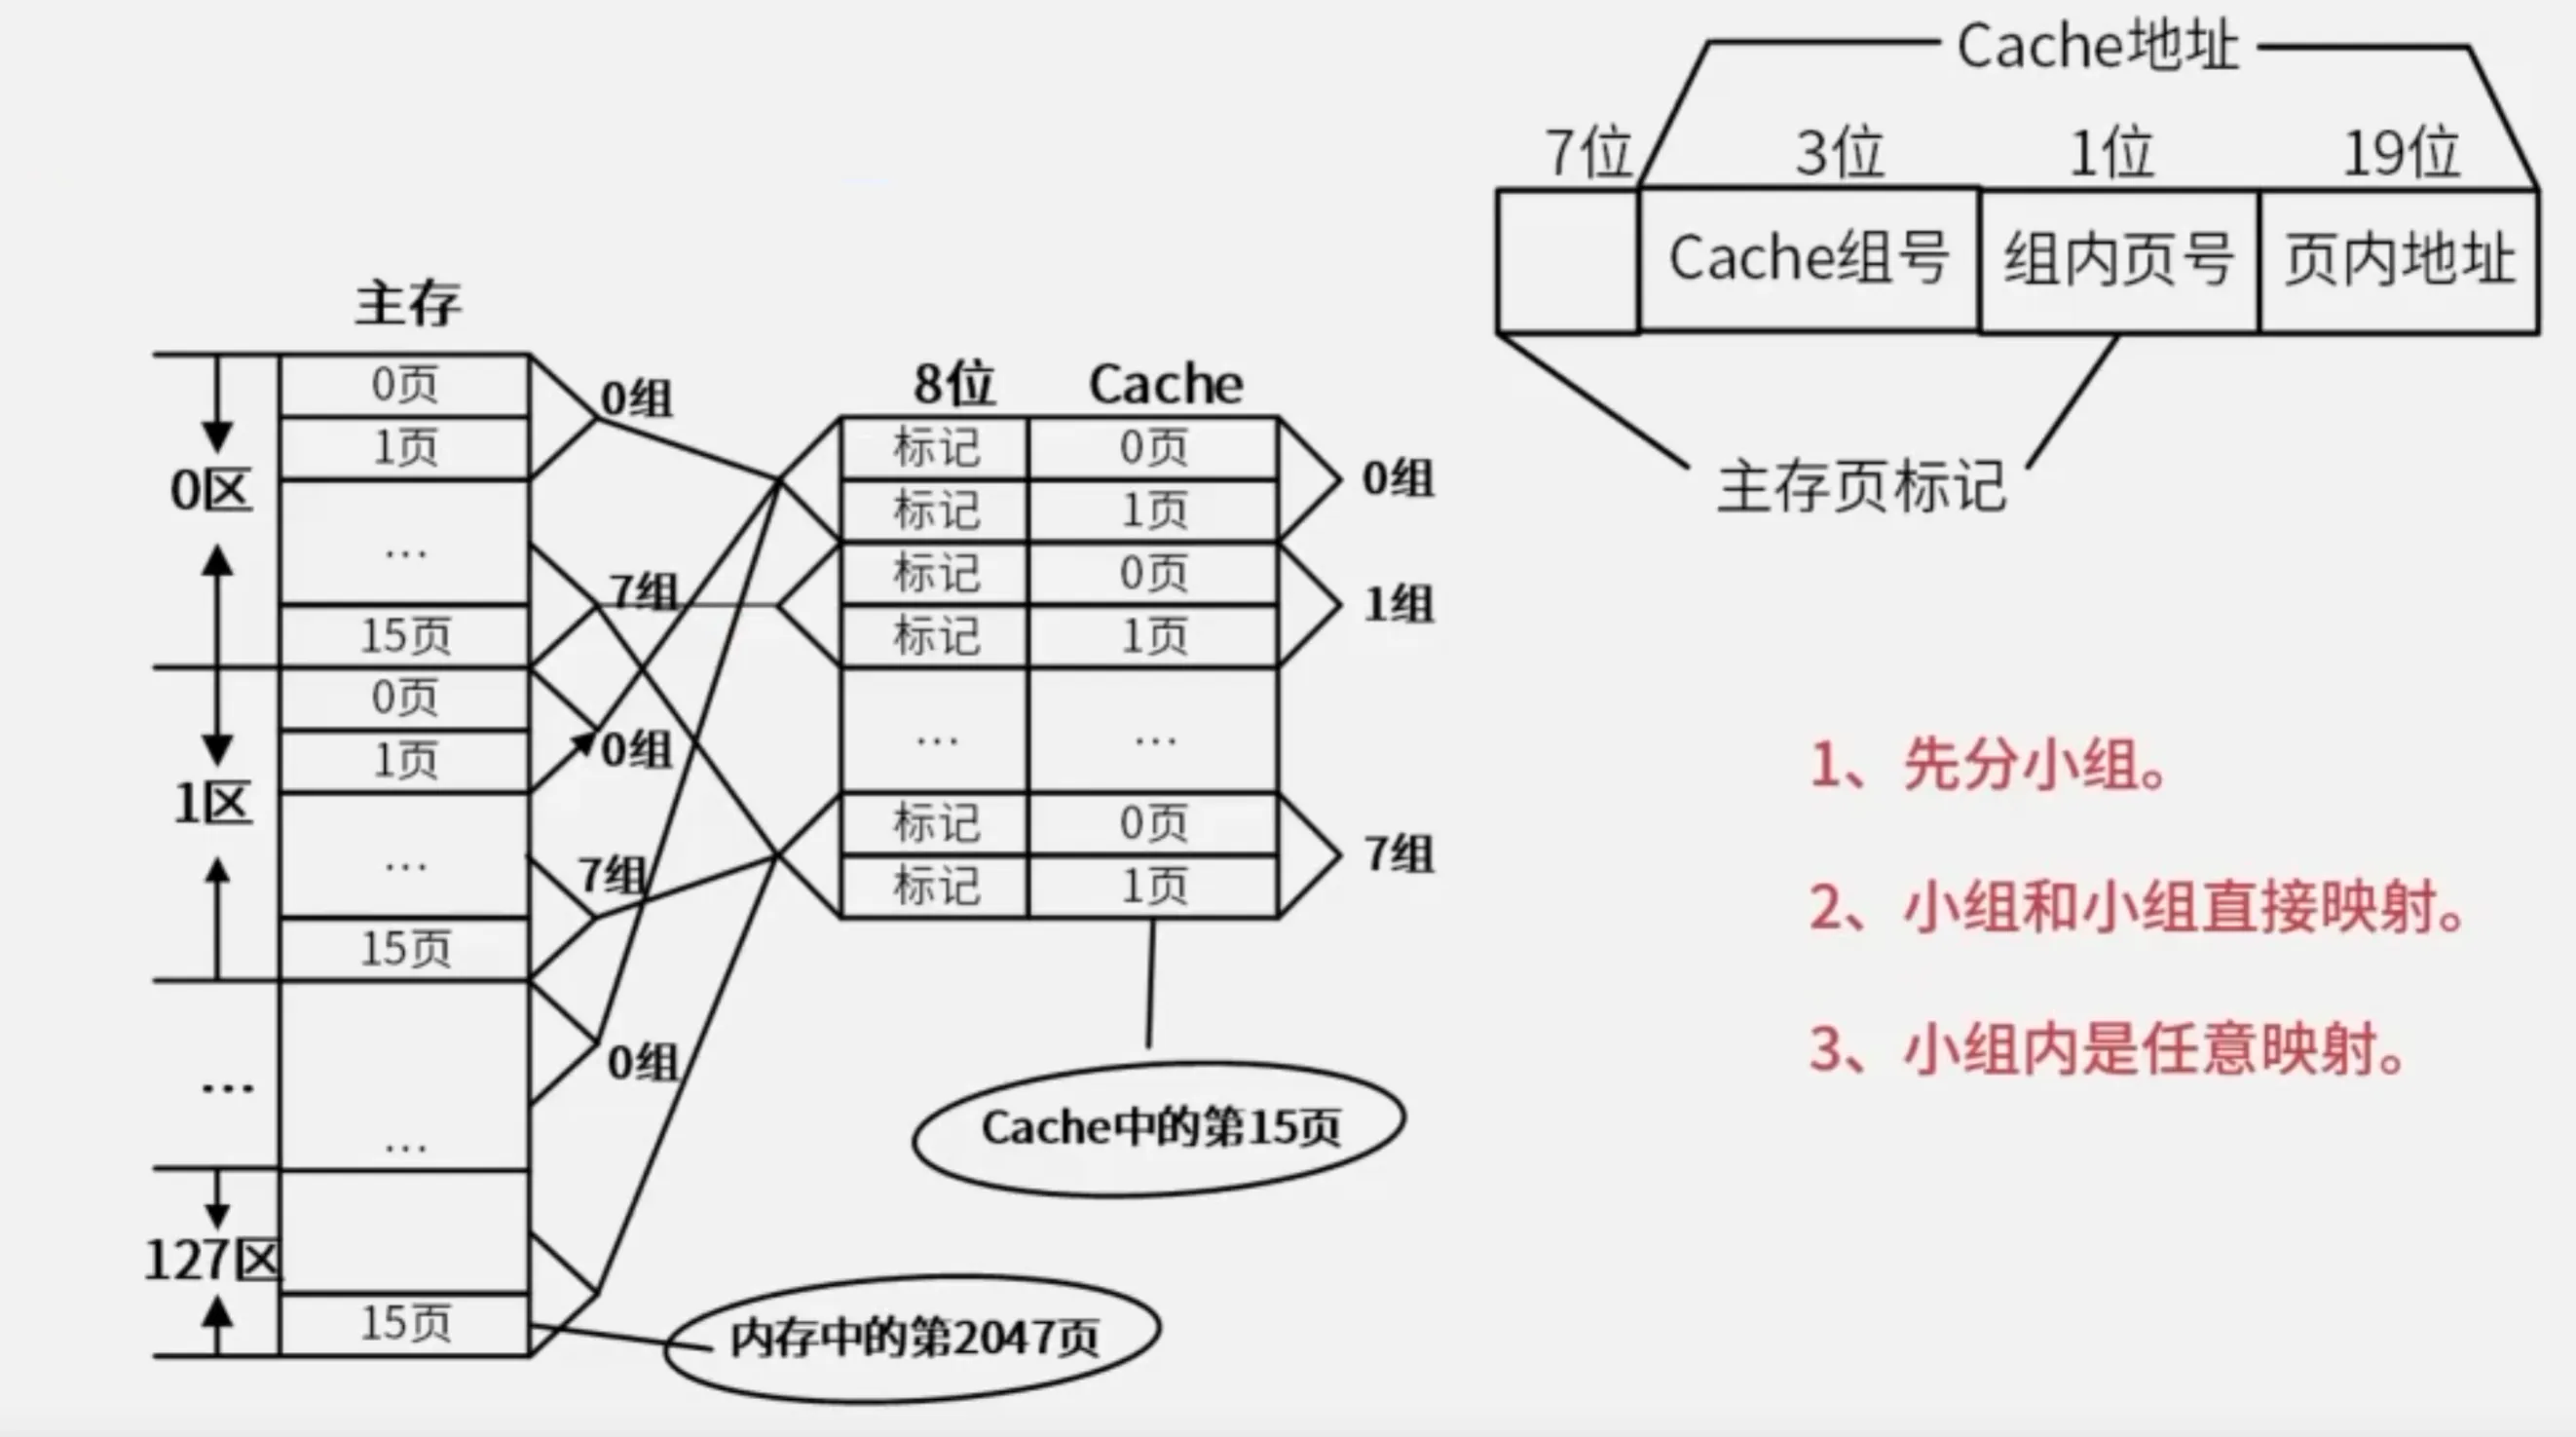 规则:**Cache 先分成若干组,组间采用直接相联,组内采用全相联**。 类比:**先按班级分固定教室(组间对号),教室里随便坐(组内自由)**。 #### 3.2.4 三种映像方式对比 | | 冲突率
(高、中、低) | 电路复杂度
(复杂、简单、折中) | 其他 | | ---- | ---- | ---- | ---- | | 直接相联映像 | 高 | 简单 | 对应位置有数据即冲突 | | 全相联映像 | 低 | 复杂 | 所有位置有数据即冲突 | | 组相联映像 | 中 | 折中 | | > ✨**直接相联 = 对号入座,一人一座** > ✨**全相联 = 自由入座,哪空坐哪** > ✨**组相联 = 先按组对号,组内自由坐(最常用)** #### 例题1 在程序执行过程中,高速缓存(Cache)与主存间的地址映射由( )。 A、操作系统进行管理 B、存储管理软件进行管理 C、程序员自行安排 D、硬件自动完成 **答案:D** 解析: Cache和主存的地址映射是由**硬件电路自动完成**,对软件、操作系统、程序员完全透明,软件感知不到Cache映射过程。 #### 例题2 主存与Cache的地址映射方式中,( )方式可以实现主存任意一块装入Cache中任意位置,只有装满才需要替换。 A、全相联 B、直接映射 C、组相联 D、串并联 **答案:A** 解析: - **全相联**:主存任意块可以放到Cache任意位置;冲突率低,Cache全部装满之后才会发生块替换,但硬件电路复杂。 - **直接映射**:主存块只能放到Cache固定位置,容易发生冲突。 - **组相联**:折中方案,只能放到指定组内的位置。 - 串并联:不属于Cache映射方式。
下一条指令的地址"] AR["AR 地址寄存器
当前要访问的内存地址"] IR["IR 指令寄存器
正在执行的指令本体"] ID["ID 指令译码器
翻译操作码"] CLK["时序部件
打节拍,同步操作"] end subgraph AU["运算器(埋头干活)"] ALU["ALU 算术逻辑单元
负责算"] AC["AC 累加寄存器
暂存数据"] DR["DR 数据缓冲寄存器
数据中转站"] PSW["PSW 状态条件寄存器
记录运算状态"] end MEM[("内存")] PC --> AR --> MEM MEM --> DR --> IR --> ID ID -->|控制信号| ALU ALU --> AC ALU --> PSW ``` ### 1.1 运算器 运算器像一张“工作台”:ALU 是台面上真正干活的工具,AC 是手边的托盘,DR 是传送带出入口,PSW 是每件活做完后贴的标签。 1. **算术逻辑单元 ALU**:数据的算术运算和逻辑运算 2. **累加寄存器 AC**:通用寄存器,为 ALU 提供一个工作区,用于暂存数据 3. **数据缓冲寄存器 DR**:写内存时,暂存指令或数据 4. **状态条件寄存器 PSW**:存状态标志与控制标志(如结果为负、为零、进位、溢出) > 争议:也有将其(PSW)归为控制器的。不同教材归类不同,考试时以所报教程为准。 ### 1.2 控制器 控制器是“车间主任”:不亲手干活,但决定**干什么、什么时候干、派谁去干**。 1. **程序计数器 PC**:存储下一条要执行指令的地址 2. **指令寄存器 IR**:存储即将执行的指令 3. **指令译码器 ID**:对指令中的操作码字段进行分析解释 4. **地址寄存器 AR**:保存当前 CPU 访问内存单元的地址 5. **时序部件**:提供时序控制信号 一图速记各部件分工: > - ALU:**算** > - AC:**临时放运算数据结果** > - DR:**CPU ↔内存 数据中转站** > - PSW:**运算状态标记** > - PC:**下一条指令在哪(地址)** > - IR:**当前要执行的指令本体** > - ID:**翻译指令** > - AR:**要访问内存的地址** > - 时序部件:**打节拍,同步所有操作** #### 1.2.1 取指令简单流程 1. PC 给出下一条指令地址 → 送到 AR,访问内存 2. 内存把指令读出,经过 DR,送到 IR 保存 3. IR 的指令交给 ID 译码翻译 4. 译码后发出控制信号,ALU 开始运算,AC 暂存运算数据,PSW 记录运算状态 5. PC 更新,准备取下一条指令 ```mermaid flowchart TD S1["① 取指:PC → AR → 访问内存"] S2["② 读出:内存 → DR → IR"] S3["③ 译码:IR → ID 翻译指令"] S4["④ 执行:发控制信号
ALU 运算 · AC 暂存 · PSW 记状态"] S5["⑤ PC 更新,准备取下一条"] S1 --> S2 --> S3 --> S4 --> S5 --> S1 ``` 这五步不断循环,就是 CPU 执行程序的“心跳”。**控制器取令发令、运算器执行计算,周而复始,程序就这样一条条跑完。** #### 1.2.2 例题 计算机执行指令的过程中,需要由( )产生每条指令的操作信号并将信号送往相应的部件进行处理,以完成指定的操作。 A、CPU 的控制器 B、CPU 的运算器 C、DMA 控制器 D、Cache 控制器 **答案:A**✅ #### 1.2.3 解析 - **A、CPU 的控制器**:控制器是 CPU 的指挥中心。读取指令、译码之后,**产生操作控制信号,发给各个硬件部件,指挥完成指令动作**,和题干描述完全匹配。 - **B、CPU 的运算器**:只负责做算术、逻辑计算,**不产生控制信号**。 - **C、DMA 控制器**:负责外设和内存直接高速传输数据,和普通指令执行无关。 - **D、Cache 控制器**:管理高速缓存,负责缓存和内存的数据调度,不产生指令操作信号。 #### 1.2.4 考点记忆 > ✨**控制器 = 发号施令(产生控制信号)** > ✨**运算器 = 埋头干活(做计算)** 题干只要出现“**产生操作(控制)信号并送往部件**”,直接锁定控制器。 ## 2. 存储系统  理想的存储器要同时满足三个愿望:**快、大、便宜**——但它们互相矛盾:快的贵,便宜的大而慢。工程师的解法是**分层**:最快的放离 CPU 最近处,最大的放远处,靠调度来兼顾三者。 ### 2.1 层次化存储体系 | 层级 | 离 CPU | 速度 | 容量 | 单位成本 | 断电后 | | --- | --- | --- | --- | --- | --- | | 寄存器 | 最近(CPU 内) | 最快 | 最小 | 最高 | 丢失 | | Cache | 很近 | 快 | 小 | 高 | 丢失 | | 主存(内存) | 较近 | 中 | 中 | 中 | 丢失 | | 外存(硬盘/U盘) | 最远 | 慢 | 最大 | 最低 | 保留 | **核心规律:越靠近 CPU,越快、越贵、越小;越远离 CPU,越慢、越便宜、越大。** #### 2.1.1 存储器位置 - **内存(主存)**:CPU 可以直接访问,存放正在运行的程序和数据。 - **外存(辅存)**:CPU 不能直接访问,数据必须先调入内存才能处理(如硬盘、U 盘)。 #### 2.1.2 存取方式 (1)按内容存取:相联存储器(如 Cache)——不问地址,按“内容”并行比对查找。 (2)按地址存取: | 方式 | 怎么取 | 通俗类比 | 典型代表 | | --- | --- | --- | --- | | 随机存取 | 给地址直接取,耗时与位置无关 | 按门牌号直接进房间 | 内存(RAM) | | 顺序存取 | 从头到尾依次找 | 磁带找歌必须倒带 | 磁带 | | 直接存取 | 先定位到区域,再在区域内顺序找 | 硬盘:先挪磁头到磁道,再等盘片转到扇区 | 磁盘 | 直接存取是介于随机和顺序之间的一种方式。 #### 2.1.3 工作方式 (1)随机存取存储器 RAM(如内存 DRAM) (2)只读存储器 ROM(如 BIOS) 四种常见存储芯片横向对比: | 类型 | 归类 | 擦写粒度 | 特点 | 典型用途 | | --- | --- | --- | --- | --- | | DRAM | RAM | — | 动态:靠电容存电荷,需刷新;集成度高、成本低 | 主存(内存条) | | SRAM | RAM | — | 静态:不需要刷新;速度快、集成度低、成本高 | Cache | | EEPROM | ROM | 按字节 | 电可擦写,小粒度、更灵活 | 主板 BIOS 配置 | | Flash | ROM | 按块 | 闪存,擦写更快、密度高 | U 盘、固态硬盘 | > **电可擦除**:不需要拔芯片、不需要紫外线照射,**通电加特定电压,就可以擦掉芯片里保存的数据,重新写入新内容**。 > - ✅用电信号就擦除,不用拆芯片 > - ✅**按字节擦写**:可以只改其中某一小部分数据,不用整片清空 > - ✅断电之后数据不会丢 > - 用途:主板 BIOS 小配置、保存少量参数 ### 2.2 例题 1 CPU访问存储器时,被访问数据一般聚集在一个较小的连续存储区域中。若一个存储单元已被访问,则其邻近的存储单元有可能还要被访问,该特性被称为( )。 A、数据局部性 B、指令局部性 C、空间局部性 D、时间局部性 **答案:C** 解析: - **空间局部性**:刚访问过的存储单元,它相邻/邻近的单元很可能马上被访问(地址相邻)。 - **时间局部性**:刚访问过的存储单元,不久之后还会再次访问(同一个地址重复用)。 判断口诀:**看到“邻近/相邻的单元”→ 空间局部性;看到“不久后再次访问”→ 时间局部性。** > ✨空间局部性 = **隔壁邻居马上也要被访问** > ✨时间局部性 = **同一个地点,回头客再来一次** 正是“空间 + 时间”这两种局部性,让下一节的 Cache 有了存在的前提:**把最近可能用到的数据提前搬到快的地方**。 ### 2.3 例题 2 计算机系统的主存主要是由( )构成的。 A、DRAM B、SRAM C、Cache D、EEPROM **答案:A** 解析: - **DRAM**:动态随机存储器,用来做**主存(内存)**,需要刷新,成本低、容量大。 - **SRAM**:静态随机存储器,用来做**Cache 高速缓存**,不用刷新,成本高。 - **Cache**:高速缓存,不是存储器芯片类型,是一种高速存储层级。 - **EEPROM**:电可擦除只读存储器,断电数据不丢失。 > ✨**便宜大碗做主存(DRAM),快而金贵做缓存(SRAM)**——这是高频固定搭配。 ## 3. Cache CPU 的速度远快于主存,直接干等主存就像跑车堵在乡间小路。解法:在 CPU 与主存之间加一层 **Cache(用 SRAM 实现)**,依据局部性原理,把最近、最常要用的那部分数据提前搬进来,让 CPU 大多数时候“就地取材”。 ### 3.1 Cache 的访问命中率 在计算机的存储系统体系中,Cache 是访问速度最快的层次(若有寄存器,则寄存器最快)。 速度排序:**寄存器 > Cache > 主存 > 外存** - $h$:Cache 访问命中率 - $t_1$:Cache 的周期时间 - $t_2$:主存储器周期时间 - $t_3$:“Cache + 主存储器”系统的平均周期(读操作) 公式: $$ t_3 = h \times t_1 + (1-h) \times t_2 $$ > $(1-h)$:失效率(未命中率) 公式的直觉:**命中的概率走 Cache 那条快路,未命中的概率走主存那条慢路,加权平均就是平均耗时。** 算一笔账:若命中率 $h = 0.9$,$t_1 = 1\,\text{ns}$,$t_2 = 10\,\text{ns}$,则 $$ t_3 = 0.9 \times 1 + 0.1 \times 10 = 1.9\,\text{ns} $$ 只用一小块 SRAM,平均访问时间就从 10ns 压到 1.9ns。**命中率是 Cache 的生命线:命中率越高,平均访问时间越接近 Cache 的速度。** ### 3.2 Cache 的三种地址映像方式 主存容量大、Cache 容量小,主存的每一块放进 Cache 时“坐哪儿”,就是**地址映像**要解决的问题。三种映像,本质是三种松紧不同的“座位制度”。 #### 3.2.1 直接相联映像 直接相联映像:地址映像是将主存与 Cache 的存储空间划分为若干大小相同的页(或称为块),**根据编号直接映射**。 > 规则:主存**各区页号相同**的页,只能映射到 Cache 里同一个页位置。  类比:**对号入座,一人一座**——主存的块按编号永远坐 Cache 的同一个座位,不管别处空不空。 - 优点:映像规则简单,地址变换快,**硬件成本最低** - 缺点:主存中同页号的块都挤同一个座位,**冲突率高、Cache 利用率低、命中率低** #### 3.2.2 全相联映像  规则:**主存的任意一页,可以映射到 Cache 的任意一页**,没有任何座位限制。 类比:**自由入座,哪个空位坐哪个**。 - 优点:最灵活,冲突率最低,**命中率最高** - 缺点:判断“数据在不在 Cache”要和**所有**页的标记逐一比较,电路复杂、成本高、速度慢 #### 3.2.3 组相联映像  规则:**Cache 先分成若干组,组间采用直接相联,组内采用全相联**。 类比:**先按班级分固定教室(组间对号),教室里随便坐(组内自由)**。 #### 3.2.4 三种映像方式对比 | | 冲突率
(高、中、低) | 电路复杂度
(复杂、简单、折中) | 其他 | | ---- | ---- | ---- | ---- | | 直接相联映像 | 高 | 简单 | 对应位置有数据即冲突 | | 全相联映像 | 低 | 复杂 | 所有位置有数据即冲突 | | 组相联映像 | 中 | 折中 | | > ✨**直接相联 = 对号入座,一人一座** > ✨**全相联 = 自由入座,哪空坐哪** > ✨**组相联 = 先按组对号,组内自由坐(最常用)** #### 例题1 在程序执行过程中,高速缓存(Cache)与主存间的地址映射由( )。 A、操作系统进行管理 B、存储管理软件进行管理 C、程序员自行安排 D、硬件自动完成 **答案:D** 解析: Cache和主存的地址映射是由**硬件电路自动完成**,对软件、操作系统、程序员完全透明,软件感知不到Cache映射过程。 #### 例题2 主存与Cache的地址映射方式中,( )方式可以实现主存任意一块装入Cache中任意位置,只有装满才需要替换。 A、全相联 B、直接映射 C、组相联 D、串并联 **答案:A** 解析: - **全相联**:主存任意块可以放到Cache任意位置;冲突率低,Cache全部装满之后才会发生块替换,但硬件电路复杂。 - **直接映射**:主存块只能放到Cache固定位置,容易发生冲突。 - **组相联**:折中方案,只能放到指定组内的位置。 - 串并联:不属于Cache映射方式。